Programování
High Availability: Jak zajistit dostupnost webu i při výpadku serveru
Výpadek jednoho serveru nemusí znamenat, že web přestane fungovat. Pokud aplikace běží na více nezávislých uzlech a provoz se umí přesunout na zdravou část infrastruktury, může služba pokračovat i při poruše. High Availability ale nevzniká pouhým přidáním druhého serveru. Záložní
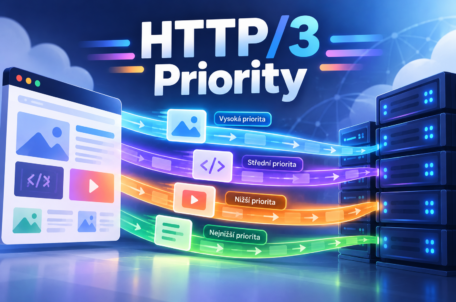
HTTP/3 Priority: Jak prohlížeče a servery určují pořadí načítání obsahu
Prohlížeč při načítání stránky žádá o HTML, CSS, JavaScript, obrázky i další soubory. Některé z nich potřebuje k prvnímu zobrazení, jiné mohou počkat. HTTP/3 umožňuje přenášet více požadavků současně, samo ale neurčuje pevné pořadí, v jakém musí server jejich obsah odeslat. O prioritě
OPcache: Nenápadná technologie, která dokáže zrychlit PHP weby
Pomalý web nemusí vždy potřebovat výkonnější server. Část času může PHP při každém požadavku ztrácet opakovaným načítáním a přípravou stejných skriptů. OPcache tento krok omezuje tím, že si jejich přeloženou podobu ukládá do paměti. Jak funguje a co zkontrolovat, aby
TTFB: Co ovlivňuje dobu odezvy serveru a jak ji zlepšit
Když návštěvník otevře web, prohlížeč nejprve čeká na odpověď serveru. Čím déle trvá, než dorazí její první bajt, tím později může začít načítání stránky. TTFB pomáhá hledat zdržení v této úvodní fázi. Ať už vzniká na serveru, v síti nebo při přesměrování.
Rychlejší inference jazykových modelů: Jak si vedou MTP, DSpark a DFlash 2
Pomalé generování tokenů a rostoucí latence při práci s dlouhým kontextem dokážou výrazně omezit využitelnost jazykového modelu. Pomoci mohou různé metody akcelerace. I klasické MTP může proti běžnému provozu přinést znatelné zrychlení. O co nejvyšší rychlost se však ucházejí také pokročilejší přístupy DSpark a DFlash 2.
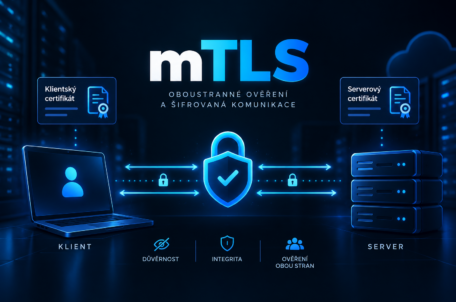
mTLS srozumitelně: Kdy se certifikátem ověřuje také klient
Certifikát běžně prokazuje identitu webového serveru návštěvníkovi. U interních služeb nebo firemních API ale může být stejně důležité vědět, kdo se připojuje z druhé strany. mTLS proto ověřuje certifikátem i klienta – třeba aplikaci, server nebo zařízení. Jak vzájemné ověřování funguje
Feature flags: Jak nasazovat nové funkce bez rizika
Nasadit novou funkci do produkce nemusí automaticky znamenat, že ji okamžitě zpřístupníte všem uživatelům. Pomocí feature flags mohou vývojáři oddělit samotné nasazení kódu od jeho aktivace. Novinku tak lze nejprve otestovat na interních uživatelích nebo malé části zákazníků, sledovat její
Disaster Recovery Plan: Co by měl obsahovat a proč je pro firmy klíčový
Výpadek serverů, ransomware, požár datového centra nebo chyba administrátora. Každá z těchto událostí může během několika minut ochromit provoz celé firmy. Právě proto vznikají Disaster Recovery Plány (DRP), které přesně popisují, jak po havárii obnovit IT infrastrukturu a vrátit klíčové systémy
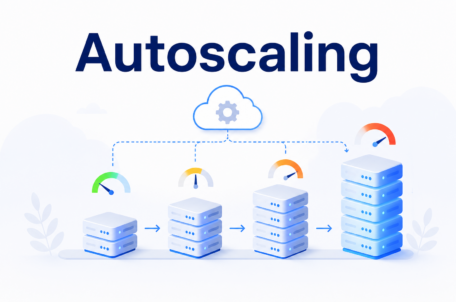
Autoscaling: Co je automatické škálování a kdy se skutečně vyplatí
Požadavky na výkon aplikací se během dne mohou výrazně měnit. Zatímco v jednu chvíli server obsluhuje jen několik uživatelů, o pár minut později může čelit tisícům požadavků. Připravit infrastrukturu na takové výkyvy není jednoduché. Příliš slabý server vede ke zpomalení, zbytečně
Blue-Green Deployment: Aktualizace aplikací bez výpadků
Každá aktualizace produkční aplikace představuje určité riziko. I drobná chyba může způsobit výpadek služby, zhoršení uživatelského zážitku nebo nutnost složitého návratu ke starší verzi. Právě proto stále více firem využívá strategii Blue-Green Deployment, která umožňuje nasazovat nové verze aplikací prakticky
State management v moderních webových aplikacích: Proč už Redux není jedinou správnou volbou
Redux byl dlouhá léta téměř neodmyslitelnou součástí React aplikací. Vývoj frontendu se ale mezitím výrazně posunul a spolu s ním i přístup ke správě stavu. Místo jediné univerzální knihovny dnes vývojáři stále častěji kombinují několik specializovaných řešení podle typu dat, se
Elektronické podpisy bez zmatků: Jak se vyznat ve formátech XAdES, PAdES, ASiC i úrovních podpisů
Elektronické podpisy jsou běžnou součástí komunikace s úřady, bankami i obchodními partnery. Přesto se kolem nich objevuje řada zkratek a technických pojmů, které mohou působit nepřehledně. Co znamenají formáty XAdES, PAdES nebo ASiC, jaký je rozdíl mezi úrovněmi B-B, B-T a
Jak navrhnout fallback infrastrukturu při výpadku cloudu
Výpadky cloudových služeb nejsou výjimečné a mohou postihnout i největší světové poskytovatele. Pokud aplikace spoléhá pouze na jednu infrastrukturu, může i krátká nedostupnost znamenat finanční ztráty nebo nespokojené zákazníky. Jak navrhnout fallback infrastrukturu, která zajistí kontinuitu provozu i v případě selhání
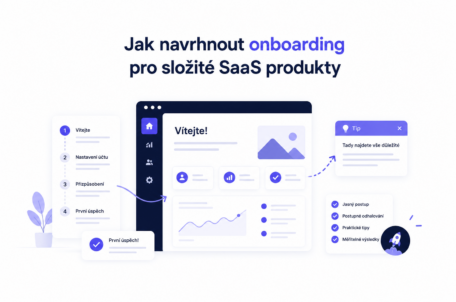
Jak navrhnout onboarding pro složité SaaS produkty
První minuty po registraci často rozhodují o tom, zda se z návštěvníka stane dlouhodobý zákazník. U složitých SaaS aplikací proto nestačí jen kvalitní funkce – stejně důležité je uživatele správně provést prvními kroky. Jak navrhnout onboarding, který zkrátí cestu k první hodnotě
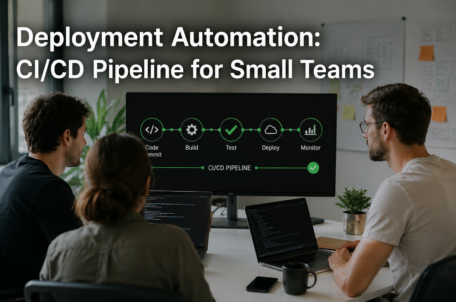
Deploy automatizace: CI/CD pipeline pro malé týmy
Ruční nasazování aplikací na produkční server bývá jedním z nejčastějších zdrojů chyb. Moderní CI/CD pipeline dokáže celý proces automatizovat, zrychlit vývoj a zvýšit spolehlivost nasazování i v malých týmech. Jak CI/CD funguje a proč už dnes není jen doménou velkých firem? Ruční